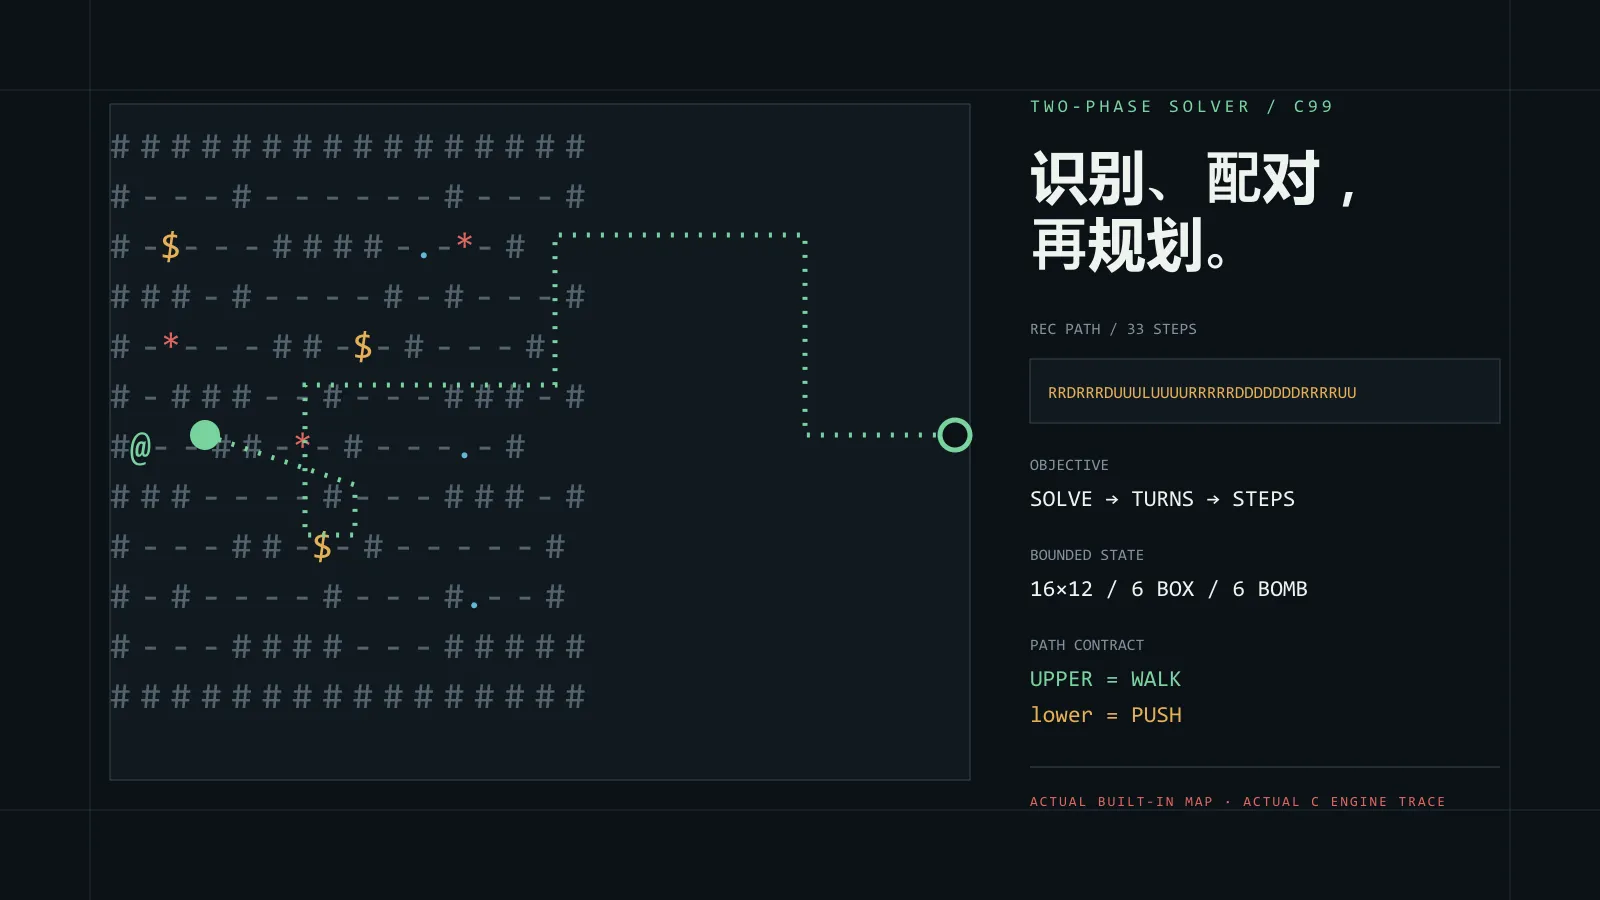
证据快照。 本文以公开仓库 sokoban-recognition-bomb-solver 的提交
94f04c2为源码基准。2026-08-30,我重新执行 GCC 构建、单元测试、50 图回归、六箱专项、性能画像与内存报告。文章中的“当前结果”来自这次复测;2026 年 7 月的数据只用于解释演化。源码、测试与最新回归优先于历史文档。
- 01 · 实测识别与规划回归
50 张主回归图识别 50/50,规划 48/50;map 37 与 map 47 的已知失败仍显式保留。
来源:94f04c2 · 2026-08-30 回归复测 - 02 · 交互浏览器中的真实 C 内核
已提交 Wasm 在内置地图输出 33 步识别路径与 191 步完整规划路径,并由 SHA-256 和行为契约共同校验。
来源:tools/solver-wasm/smoke.mjs
摘要:它究竟是什么,已经做到哪一步
这不是传统 Sokoban 加一个炸弹图标,也不是摄像头数字识别程序。它是一套面向 16×12 有界矩阵的 C99 规划内核:输入墙、小车、箱子、出口和可推动炸弹的符号地图,先生成“去哪里观察、从什么方向观察”的识别路径,再接收外部识别出的编号,决定同号箱子与出口如何配对,随后安排推弹炸墙、推箱入库和可选返航,最后从初始状态逐字符重放结果。
截至当前提交,它已经从机器人 main.c、串口、摄像头与 Keil 工程中独立出来,形成可单独构建、测试、分析和编译为 Wasm 的静态库。它不是完备求解器,也不是线程安全的通用库。更准确的定位是:
一套工程化、确定性、静态有界、以少转向优先的比赛型启发式规划器。
| 维度 | 当前结论 | 证据与边界 |
|---|---|---|
| 识别阶段 | 主回归 50/50 | 不等于所有合法地图都能完整扫描;当前成功判据仍有语义缺口 |
| 规划阶段 | 主回归 48/50 | map 37、47 识别成功但没有完整规划候选 |
| 路径质量 | 共同解出的 48 图累计少 111 转、少 46 步 | 目标是完成 → 转向 → 步数,不是纯最短步数 |
| 六箱支持 | 专项图识别 32/7,总路径 110/38 | 默认无标签配对在 6 箱时会退化为 Manhattan 贪心 |
| 内存模型 | 求解时无堆分配,静态上界清楚 | SolverContext 已约 139 KiB,另有全局缓存,不属于小内存 |
| 并发能力 | 单调用链确定、可复现 | 共享 g_ctx 与静态工作区,不可重入、非线程安全 |
| 工程成熟度 | 有 CMake、GCC/Clang CI、ASan/UBSan、单测、回归与画像 | 尚无许可证、稳定 ABI、硬件当前源码 Clean Build 证据 |
仓库现有 21 个 src/*.c,共 12,788 行;其中 20 个源文件组成核心静态库,另一个是可选控制台动画。13 个测试与基准 C 文件共 2,124 行,11 个头文件共 1,326 行。测试地图目录有 52 张地图:50 张进入主回归,另外两张承担六箱与专项验证。这个规模已经足以要求架构纪律,但还没有大到必须用动态框架掩盖所有状态。
一、先把问题说准确:这是动态拓扑上的分阶段规划
1.1 状态不只有玩家和箱子
可以把任一时刻的状态写成:
S = (G, p, X, B, E, Cx, Cb, P, L)
G   当前墙网格,爆炸后会改变p   小车位置X   所有箱子的位置、目标与完成标志B   所有炸弹的位置、目标与完成标志E   出口集合Cx  箱子占用表Cb  炸弹占用表P   箱子—出口配对L   已生成路径及其末方向
普通 Sokoban 中墙通常是常量;这里炸弹被推入非边界墙后,会清除爆点 3×3 范围内的非边界墙。于是 G 是搜索状态的一部分,玩家连通域、箱子推位、死锁判断和后续炸弹候选都会改变。只按“玩家和箱子坐标相同”合并状态并不安全。
识别本身也不是只读阶段。识别路线可能推开箱子、推动炸弹并引爆墙,因此识别结束后必须输出完整 end_map。规划阶段的输入是它,而不是原始地图。这一条合同如果被 MCU 桥接层忽略,后续路径从第一步起就可能与真实世界不同。
1.2 动作字母表是一份执行协议
路径由八个字符组成:
| 字符 | 含义 | 执行约束 |
|---|---|---|
U R D L |
向上、右、下、左普通行走 | 目标格不能是墙、箱子或不可穿越炸弹 |
u r d l |
沿相同方向推动实体 | 下一格必须有箱子或炸弹,实体前方必须合法 |
大小写不是视觉标记。路径重放器、导航切段器和浏览器展示器都依赖它判断“走”还是“推”。转向统计会忽略大小写,所以 RRrrDD 只有一次方向变化;但切段时“推后转走”和“走后进入推”有不同协议语义。
内部坐标统一为 (x, y) = (列, 行)。历史 MCU 下发 <PATH,row,col> 时会交换顺序。早期出现的异常运动、起点纠偏丢失和 g_dx/g_dy 问题属于执行层;求解器只输出网格路径与端点,不生成视觉偏差值。把这两个边界分开,是后来抽离独立仓库的重要原因。
1.3 目标函数不是一个加权和
当前全局解比较器采用字典序:
Q(path) = (solved, -turns(path), -length(path))也就是:
- 完整合法解永远优于不完整解;
- 都完整时,方向变化更少者优先;
- 转向相同才比较总步数。
这不是把 turns 乘一个经验系数后和长度相加。真实小车转向通常比直行更慢,也更容易积累定位误差,因此用户明确要求“少转弯优先于短路径”。map 50 正好展示了这个取舍:当前解为 184 步、69 转,旧基线为 176 步、75 转,算法有意用 8 步换 6 次转向。
但这一目标还没有贯穿所有局部层。无标签默认箱口配对在 5 箱以内先按路径长度选配对,转向只是次级指标;推箱底层又在三个不同权重的 A* 结果之间使用混合分数。这种“全局字典序、局部历史启发式”的不一致,是当前代码最重要的算法债之一。
二、完整数据链:从地图到可执行结果
当前公共入口位于 solver_engine.h。标准调用不是一个黑盒 solve(),而是显式的两阶段合同:
SolverInput │ ├─ solver_recognition_into │ ├─ recog_path │ ├─ recog_targets[] / yaw / skip_scan │ ├─ start_pos │ └─ end_map │外部摄像头在目标点采集编号 │ ├─ solver_resolve_labeled_pairing │ └─ box_exit_pairing[] │ └─ solver_planning_into(end_map, pairing, return_pos) ├─ solve_path ├─ completion statistics ├─ return_path_failed └─ fail step / fail reason推荐使用 *_into 版本,因为调用方持有 SolverResult 缓冲区,避免在嵌入式 ABI 上按值返回约 8.5 KiB 的结构。当前 by-value API 已经改为包装 into API,不再维护一份数百行的重复规划流程;这修复了历史上两条实现逐步漂移的问题。
SolverResult 同时携带:
- 识别路径、规划路径及长度;
- 识别目标类型、稳定索引、坐标、停车朝向和
skip_scan; - 识别末地图、原始起点和请求返航失败标志;
- 解析、无箱路、死锁、无炸墙候选、组合失败、验证失败和超时等原因;
- 箱子完成数、炸弹引爆数与 API 计时。
当前 solve_time_ms 已在最终后处理后重新取时,因此结果字段包含截断、返航、路径优化和最终验证。规划函数中较早打印的内部日志时间仍只覆盖主搜索,阅读日志时不能把两者混为一个指标。
2.1 API 边界仍有历史遗留
solver_is_first_level 仍把“箱子数不超过 2”称为一级图。这只是旧 MCU 流程遗留的地图启发式,不等价于后来实际采用的“启动后的第一关走 L1 状态机”规则。独立求解器仓库没有关卡计数,也不应该决定启动语义。
同样,固定回家点 (6,1)、回家失败时退回原起点、关闭编码器物理后退但保留旋转归零,都是历史 MCU 调用策略。库本身只接收可选 return_pos;传什么坐标、失败后是否重算,由应用层决定。
三、可运行的浏览器实验台:真实内核,但不是所有外设
下方控制台加载的是 181,569 字节的 wasm32-wasi 模块。构建脚本使用 Zig,把独立仓库中与 CMake 静态库相同的 20 个 C 源文件和一个薄桥接层编译进 Wasm;求解在 Web Worker 中运行,页面线程只负责输入、状态展示与路径重放。
LIVE CORE / C99 → WEBASSEMBLY
把 C 内核的完整路径真正执行一遍
等待 C 内核返回路径INPUT
- STEP
- 00 / 00
- TURN
- 0
- POSITION
- —
路径会在求解后逐步展开。
路径、完成数和引爆数来自真实 C99 → Wasm 内核;浏览器只按原 `anim_engine` 语义重放。大写表示行走,小写表示推动。炸弹进入墙格时触发 3×3 清墙动画,非法路径会在对应步骤中止。
这套演示的证据价值与边界都应说明:
- 它运行真实 C 内核,不是 JavaScript 重新实现的“相似算法”。
- 浏览器用另一份规则解释器逐字符回放 C 输出;越界、撞墙、空推、实体冲突会在对应步骤停止,形成异构交叉检查。
- Worker 外层有 60 秒超时,超时后直接终止并重建 Worker;C 内核内部还没有 cooperative cancellation。
- 演示没有摄像头标签输入。桥接层对规划传入
NULLpairing,因此展示的是无标签默认配对,不覆盖重复编号与缺失编号恢复。 - 浏览器回放器不是仓库中的
anim_engine.c。后者是可选控制台动画;网页使用独立 TypeScript 规则回放。 - Wasm 构建脚本要求显式提供求解器源码根目录与 Zig 可执行文件。站点目前保存成品和 smoke test,但没有把源码提交哈希嵌进二进制,未来同步时仍应增加哈希清单以防版本漂移。
四、模块架构:目录已经解耦,状态所有权还没有完全解耦
当前 20 个内核源文件按职责拆成:
| 层 | 目录 | 实际责任 |
|---|---|---|
| Facade | src/facade |
公共 API、双识别编排、结果构造、最终验证 |
| Context | src/context |
输入复制、解析初始化、历史规则与后处理 |
| Board | src/board |
占用表、快照、爆炸和网格状态 |
| Search | src/bfs、src/search |
玩家、箱子、炸弹搜索及查询缓存 |
| Recognition | src/recognition |
观察目标、停车位、顺序、机会识别与推弹交错 |
| Pairing | src/pairing |
箱口标签、默认配对、炸弹—墙配对与组合 |
| Preclear | src/preclear |
推走阻弹箱,必要时用弹为箱造空间 |
| Planning | src/planning |
混合行为排列、递归求解、评分与返航修复 |
| Transaction | src/txn |
对 GameSnapshot 的作用域式包装 |
| Path | src/path |
转向/推动指标、路径切段与导航序列 |
这比最初八个大文件堆在 MCU 工程里好得多:公开头和内部头分开,算法改动可以在 PC 上回归,main.c 不再是求解器构建依赖。
然而源码目录的模块化还没有变成完整的状态所有权。SolverContext g_ctx、SolverResult g_result、第二识别候选、方向搜索数组、识别转移表、推箱缓存和递归状态表都使用全局或静态存储。它们避免堆分配、让峰值可预测,却也意味着:
- 同一进程不能并发求两张图;
- 不能在中断和主循环同时调用;
- 两个独立调用者不能各自配置缓存;
- 小内存平台无法只按需裁剪某一工作区;
- 测试必须重置全局缓存,不能仅销毁一个实例。
因此,“高内聚低耦合重构已完成”的准确说法应是:职责目录已经建立,实例所有权与规则/搜索边界仍未完成。
五、识别阶段:观察位规划、顺序搜索与炸弹交错
5.1 识别的是停车位,不是目标格
箱子和出口本身通常不可站。对每个目标,算法检查四个相邻格,排除墙和实体,求小车到候选停车位的路径,再根据目标相对停车位的位置给出 yaw:
| 目标相对小车 | yaw |
|---|---|
| 上方 | 0° |
| 右方 | -90° |
| 下方 | 180° |
| 左方 | 90° |
路径执行时还会逐步检查邻格。如果沿途已经经过另一个未识别目标的观察位,会机会式把它加入 recog_targets,而不是坚持走完预定顺序再回来。这使“目标顺序”更像访问优先级,不是一条不可变的旅行商路线。
5.2 双候选不是“排列 vs 贪心”,而是兼容语义 vs 转向优先语义
solver_recognition_into 默认完整运行两次:
- 兼容候选:保留旧排序与旧玩家路径语义,用作行为基线。
- 优化候选:启用方向状态最短路、转向优先顺序和转移缓存。
日志中仍有 greedy 旧命名,但当前第二候选实际是 bounded bitmask search,不应再按日志名字理解算法。
两条候选都生成真实路径与 end_map,随后由统一比较器按转向、长度选择。若两条路线留下相同末地图,优化候选只要更优即可替换;若末地图不同,至少要减少 5 次转向才允许替换。这个门槛保护后续规划:识别局部少一两转,却把炸弹留在更差位置,可能让总任务从可解变成无解。
代价是识别计算近似翻倍。目标数上限为 12,默认双跑限制也是 12,所以当前合法最大图都会尝试两条候选。
5.3 为什么玩家最短路必须保存入射方向
若 visited 只有 cell,同一个格第一次以“向上”到达后,另一条以“向右”到达的路径会被丢弃;但下一段继续向右时,两者的新增转向不同。优化搜索因此使用:
state = (cell, last_direction)edge_cost = 1 + [direction changed] × 1024地图最大单段远小于 1024 步,所以这个 stride 实现的是严格“少转向优先、步数次之”,不是近似权重。共有最多 192 × 4 = 768 个方向状态,使用二叉堆 Dijkstra。起点若没有历史方向,会同时初始化四种方向;若识别路径已有前缀,则把最后移动方向带入下一段,连段边界也能正确计转向。
5.4 小目标精确枚举,大目标有界 beam
识别顺序最多包含 12 个目标。当前策略是:
- 剩余目标不超过 8:枚举排列,最多 50,000 次评价或 800 ms;
- 9 至 12 个:宽度 128 的 beam;
- 超出预算:保留最好完整候选,若没有则保留覆盖目标最多的部分候选,再按稳定顺序补齐;
- 兼容候选只允许最多 10 个目标进入旧排列,更多时回退最近邻。
节点保存 (car, mask, cost, turns, last_move, order)。mask 不只标记主动选择的目标,还合并路径上机会式识别到的目标。对固定拓扑,(source cell, target) 的停车位、长度、首尾方向和机会掩码会进入转移缓存,避免每个排列重复跑玩家路径。
一旦炸弹移动、墙被炸开或实体位置变化,32 位拓扑签名改变,剩余目标顺序会从实际小车位置重新计算。它不是一次算完后机械执行。
5.5 O13 单跳过:有用,但它是标签协议的一部分
识别开始前会预选恰好一个 skip_scan 目标。算法枚举每个单目标,以 Manhattan 最近邻巡游估计“跳过它后的路线”,选估计最短者。被跳过目标仍写入 recog_targets,但 yaw 设为 0 并标记 skip_scan=true,调用方应保留路径起点纠偏,只跳过该目标的旋转和拍摄。
为什么最多只跳一个?因为标签恢复依赖箱子与出口编号的多重集合差。其余目标都识别后,一个未知项通常能由另一侧缺失的编号唯一推出;跳过多个目标会迅速出现组合歧义。
当前跳过选择仍只是 Manhattan 估计,没有调用真实方向最短路,也没有把“这个标签是否真的能唯一恢复”纳入预选。独立配对 API 会在不能证明时返回 NEEDS_RESCAN;历史 MCU 曾选择不让 NEEDS_RESCAN 阻断流程,转入稳定任意配对回退。那是应用层的可用性折中,不属于当前库的正确性保证。
5.6 推弹已全局交错,而非识别前一次性清场
当前默认:
RECOG_PHASE0_PAIR_ONLY=1:阶段 0 只配炸弹—墙,不立即推;RECOG_INTERLEAVE_BOMBS=1;- 每识别 2 个目标重新评估一次推弹机会;
- 最多可使用全部炸弹,不强制给 planning 预留固定数量;
- 每次候选推弹后检查默认箱口配对可推,以及每个箱子至少有一个出口可达;
- 推弹失败、被机会识别打断或安全检查失败时恢复快照和识别路径长度。
若目标停车位不可达,系统先尝试预配墙,再枚举该炸弹可达墙,模拟 3×3 爆炸后检查停车位是否连通;找到有用炸点才真正生成推弹路径。若炸弹本身无墙可达,会先调用 preclear 推走阻挡箱。若某炸弹被锁死,还可以用另一枚自由炸弹炸开它的接近空间。
5.7 当前识别阶段的三处诚实缺陷
主回归 50/50 并不意味着识别完成语义已经严格。
fill_recog_result仍用recog_path_len > 0设置solved。合法零步识别会被判失败。- 找不到停车位、无法开路或无炸弹时,主循环会把目标标成 visited 后继续,但不一定把它记录为一个合法扫描目标;最终也没有用“所有必扫目标均完成或恰有一个 O13 跳过”作为成功判据。因此某些未覆盖地图可能出现“走过一段路所以 solved=true,但实际漏扫”。
- 解锁链路两处用于禁止机会识别的 6 元素 dummy 数组只显式写了 5 个
true,第 6 项由 C 初始化为false。六箱专项没有触发这一反例,但六目标解锁路径存在被第六项意外打断的风险。
这三项都应先用单元测试固定,再谈更激进的识别 beam。它们是判定语义问题,不是调一个权重能解决的问题。
六、编号配对:重复标签不是冲突,而是等价类
6.1 同号箱子和出口允许任意一对一匹配
假设箱子标签为 [1, 1, 2],出口标签也是 [1, 1, 2]。两个 1 号箱不必按识别顺序绑定两个 1 号出口。当前配对器会:
- DFS 枚举所有满足标签相等且出口不重复的匹配;
- 用箱到口 Manhattan 总和排序;
- 只保留 Top 8;
- 暂时把炸弹视为已完成,对每个候选调用真实推箱求解;
- 按转向优先、路径长度次优、Manhattan 再次优选最终配对。
这比“同号按数组下标配对”可靠,但仍不是全局最优证明:Top 8 预筛可能丢掉 Manhattan 较差、实际推箱更好的候选;评价时又暂时忽略炸弹,所以没有衡量某配对与炸墙计划的联合价值。
6.2 一个未知箱和一个未知出口如何恢复
0 或 ‘?’ 表示未识别。算法对 256 个可能标签维护箱侧计数减出口侧计数:
- 只有一个未知箱:必须恰好有一个出口标签在箱侧缺失;
- 只有一个未知出口:必须恰好有一个箱标签在出口侧缺失;
- 两侧各一个未知且已知多重集合已平衡:给二者同一个 synthetic 标签;
- 两侧各一个未知且各有一个正负差:交叉补齐;
- 任一侧未知超过一个,或差值不能唯一解释:
NEEDS_RESCAN。
补齐后会重新核对完整多重集合,再进入同号 DFS。也就是说,skip-scan 的安全不是“只跳一个就绝对没问题”,而是“只跳一个让唯一恢复在多数协议输入中可证明;证明失败时 API 会拒绝猜测”。
6.3 没有标签时,默认配对走另一套目标
solver_planning_into(…, NULL, …) 会自行选择箱口配对:
- 1 至 5 箱:枚举所有出口排列,暂时忽略炸弹,用真实箱子求解评价;长度优先,转向次之;
- 6 箱:不枚举 720 种配对,改用全局最近 Manhattan 贪心;
- 评价全部失败:仍保留 Manhattan 最小的候选作为回退;
- 出口少于箱子:默认配对失败,Facade 最后会退回同下标配对。
这是此前“L1/实际使用未传 pairing 时选择总路径更短配对”的实现结果,也解释了网页演示的行为。它和带标签配对、最终规划的 turns-first 不同。若以后要求目标函数全局一致,应先决定默认配对是否也改为 turns-first;不能只改日志或最终比较器。
七、炸弹配对:决定的是未来拓扑,不只是推送距离
7.1 一次搜索收集所有可达墙
对一枚炸弹逐墙运行 A* 会非常昂贵。ctx_collect_bomb_walls 在联合状态 (player, bomb) 上遍历一次:普通空格继续扩展;炸弹下一步撞到非边界墙时,把该墙标为候选但不把墙状态继续展开。结果是一张可达墙位图,供识别预分析、解锁、preclear 和 planning 配对复用。
边界墙永远不作为爆点。真实爆炸只清 3×3 内的非边界墙,外框保留,以维持有界地图合同。
7.2 识别预配对如何给墙评分
识别预分析对每枚炸弹最多保留 8 面墙:
- 候选墙与炸弹 Manhattan 距离不超过 10;
- 先按 3×3 内可清墙数排序;
- 模拟爆炸后,用默认下标箱口配对重算推箱总代价;
- 记录代价降低量;
- 用 min-regret 顺序分配,避免多个炸弹抢同一面墙;
- 随后在原墙 3×3 邻域寻找更容易推到、效果可接受的等效墙。
这套评分比只数清墙数更接近下游任务,但仍把“默认下标配对”当作代理,不知道真实摄像头标签。识别发生在标签获得之前,这个信息缺失无法完全消除,只能靠保守安全检查和末地图门槛控制风险。
7.3 五类炸弹分配至今仍没有统一数据模型
历史文档把炸弹用途分成五类:
| 类型 | 用途 | 当前主要存储 |
|---|---|---|
| Recognition pre-push | 识别前/识别中预推 | recog_bomb_walls[] |
| Unlock | 用自由弹解锁被困炸弹 | 局部变量,执行后即消失 |
| Planning Phase A | 简单规划配对 | bombs[i].target |
| Planning Phase B | 递归重配对与 Top-N | target、top_combos |
| Reposition fallback | 不撞墙,只把炸弹推到空地 | 递归局部候选 |
等效墙优化已经覆盖识别、解锁、Phase A 和 Phase B 顶层,但字段仍分散在 alt_targets、opt_bomb_targets、top_combos 等位置。历史提出的统一 BombAllocation 从未真正落地。它仍是合理重构方向,但必须在保持搜索顺序的前提下渐进迁移。
八、preclear 与弹箱协同:为了推弹,先移动箱;为了移动箱,先炸墙
8.1 从“完全无墙可达”扩展到“候选太少”
早期 preclear 只在炸弹可达墙数为 0 时寻找阻挡箱。当前阈值为:
若 wall_count == 0:精确找阻挡箱若 wall_count < 3:临时移除附近箱子并重测若移除后至少多 2 面可达墙:把该箱列为值得推走临时把箱子设为 completed 是一种占用模拟,不是说箱子真的已经入库。调用结束前必须恢复 completed、位置、占用表和路径;否则一个试探分支会让后续统计少一个箱。
8.2 没有安全空位时,用另一枚炸弹创造空间
ctx_bomb_create_box_space 处理更复杂的闭塞:
- 当前阻挡箱找不到安全空位;
- 枚举未完成、可用的其他炸弹及可达墙;
- 模拟 3×3 爆炸;
- 检查爆炸后是否新增箱子安全位;
- 检查消耗这枚炸弹后,剩余任务仍有足够资源;
- 真正执行推弹、引爆、推箱;
- 任一步失败都恢复地图、实体、玩家和路径。
这就是“弹箱协同”而非固定顺序流水线:推箱可以为弹开路,推弹也可以为箱造空间。它提高了策略表达力,也让快照语义和最终回放变得不可省略。
九、规划编排:便宜策略先跑,昂贵搜索逐级接管
solver_planning_into 的主要流程如下:
| 阶段 | 行为 | 静态边界 |
|---|---|---|
| Pair boxes | 应用外部 pairing,或执行默认配对 | 5 箱内枚举,6 箱贪心 |
| Preclear | 推走阻碍有效炸墙候选的箱子 | 6 箱、6 弹固定数组 |
| Phase A | simple bomb-wall pairing + 等效墙 + 炸弹顺序排列 | 候选有界 |
| Chunk-2 | Phase A 只完成部分时,在爆炸后网格重配剩余弹 | 只处理当前剩余项 |
| Phase A+ | 让固定顺序炸弹与任意箱子顺序交错 | 最多评价 500 个排列 |
| Phase B pairing | 枚举炸弹—墙组合并用真实箱子求解评价 | 最多 5,000 个组合 |
| Phase B+ | 对最优配对先跑混合排列,再跑递归策略 | 递归深度 16、分支 4 |
| Top-N retry | 最优组合失败时重试次优组合 | Top 5 加 best |
| Box-only | 所有炸弹策略失败后尝试纯推箱 | 仍要求完整回放 |
Phase A+ 的动作序列不是任意 12 个实体的全排列。炸弹内部顺序保持固定,算法枚举炸弹在总序列中的槽位,再枚举箱子顺序,最多尝试 500 个。找到完整箱解后会跳过剩余无用炸弹。
Phase B 的 5,000 个组合也不等于完整搜索。每层候选上限会随剩余深度收紧,组合缓存只有 256 项直接映射,递归还有时间和分支上界。它是 bounded exhaustive fallback,更准确的中文是“有界组合枚举”,不是数学意义上的穷尽全部合法计划。
仓库里有一个 strategy_registry.c,列出 return repair、dead bomb filter、bomb unlock、interleaved beam 和 state cache。当前只有 return repair 标为默认启用,而且注册表没有被规划编排器消费;它是路线图元数据,不是插件系统。把它描述成“策略可动态注册”会夸大当前架构。
十、推箱底层:三遍联合 A* 是质量来源,也是主要热点
10.1 单次查询的状态与转移
ctx_bfs_push_one_box 在联合状态 (player, selected_box) 上搜索。玩家可在空格行走;当下一格是被选箱子时,若箱前格合法就产生推动。其他箱子、墙和按模式启用的炸弹会阻塞。
A* 启发式由目标反向预计算的网格距离参与,节点还保存父索引、动作、步数和累计转向。单次查询有:
- 最多 4,992 个节点;
- 最多 200,000 次展开预算;
- 单条内部路径上限 512;
- 约
192 × 192的玩家—箱位置 visited 位图。
10.2 为什么同一个问题跑三遍
包装层依次运行:
| Pass | 转向权重 | 内部评价 |
|---|---|---|
| balanced | 1 | g + h + turns |
| shortest | 0 | g + h |
| straight | 3 | g + h + 3×turns |
然后再比较三个返回路径。这里存在一个微妙的不一致:前两个候选以 len + turns 评价,第三个以 len + 3×turns 评价,却与前面保存的分数直接比较。它不是严格的全局 turns-first,也不是同一权重下的三候选比较,而是历史经验组合。
曾经尝试把三遍替换成单个更大的联合状态搜索,以及构建 push graph 原型。map 14、23 反而约慢三倍:减少外层候选没有消除“每个箱位置重复求玩家可达域”这一最贵工作。这个失败很有价值,它说明正确的底层优化顺序应是先复用玩家连通域,再统一搜索。
10.3 64 项推箱查询缓存为什么仍能显著提速
高层配对和递归会重复询问完全相同的“在这张板面上,从这个玩家位置,把第 i 个箱推到目标”的问题。当前缓存为 16 set × 4 way,每项保存:
- 两个 64 位指纹;
- 命中时间戳;
- 成功路径或空字符串失败结果;
- 最多 191 个路径字符。
键包含地图尺寸、当前墙网格、所有箱子/炸弹的位置与完成标志、玩家位置、目标、箱索引和 bombs_are_obstacle。这比只哈希玩家、箱子和目标昂贵,但爆炸前后坐标相同不代表板面相同;完整状态是缓存正确性的代价。
每次新输入复制到 context 时缓存会清空,长于 191 的结果拒绝缓存。缓存失败结果同样重要,因为高层会反复探索不可达配对。
十一、状态、事务与回滚:快照不是完整事务
GameSnapshot 保存玩家、箱子、炸弹和当前网格,大小 304 字节。SolverTxn 提供 begin / rollback / commit 的可读外壳,但它没有保存:
recog_path_len、full_sol_len和路径字节;- manual pairing 与 pair target;
- fail reason、失败实体索引;
- return position 与失败标志;
- 启发式、查询缓存和识别转移缓存。
更复杂的是路径缓冲是 union:识别路径和完整规划路径共享 512 × 8 = 4096 字节。preclear 在识别阶段借用 full solution 区时,调用者必须先把 recognition path 复制到另一个静态缓冲,执行后再拼回去。源码中大量 saved_len + static char saved_path[] + GameSnapshot 正是这一现实的痕迹。
所以当前事务层的成熟度应评价为:
它把板面回滚做成了统一原语,但还没有把一次搜索决策的全部副作用收进事务。
下一步最稳妥的改进不是立刻复制整个 SolverContext,而是先新增 PathCheckpoint 和统一 candidate commit API,再把 pairing、失败状态和缓存失效逐步纳入。
11.1 递归状态缓存为何默认不剪枝
4096 项状态表曾尝试按“物理状态相同、当前路径更差”剪枝。反例表明,仅看实体坐标会忽略目标配对、炸墙候选、路径末方向和前缀质量,导致合法候选被错误支配,出现转向或步数回退。
当前保守哈希甚至包含完整路径前缀、目标、配对、墙网格、freeze zone、Top-N 和深度。身份足够严格后,实际工作负载几乎没有可复用状态:本次 profile 中 map 47 只有 1 次 state-cache lookup,map 50 有 7 次,命中均为 0。于是观察代码保留,SOLVER_STATE_CACHE_PRUNE 默认关闭。
这是一个很好的负面工程结论:缓存“命中率高”不自动意味着可安全剪枝;状态等价关系必须先证明。
十二、后处理与返航:找到解之后仍可能把解弄坏
历史基线中 map 13、26、45 的主规划曾经已经成功,却在返航或最终验证阶段被误杀。当前后处理按顺序执行:
- 从末尾向前检查每个 push 边界,若箱子已全部完成,则截掉后续无用推弹;
- 从规划初态重放 raw plan,确认动作合法且所有箱子完成;
- 在真实末板面上 BFS 到请求
return_pos; - 拼接后重新从初态重放完整路径并核对终点;
- 尝试 push swap 与 walk segment reconnect;
- 优化结果只有在更短、动作合法、箱子完成且返航终点不变时才接受;
- 最后再做一次完整验证并统计完成实体。
请求返航不可达时,库保留原始箱解、设置 return_path_failed=true,而不是把一个已经完成的规划清空。历史 MCU 再据此决定是否改用原关卡起点重算。
项目已经删除独立的 return_path_shortener 思路。当前仍保留必要的尾部截断、返航修复和局部路径优化,并且最终比较逻辑仍是转向优先;没有再引入一个只追求返航短路、可能改变执行语义的独立模块。
十三、内存与嵌入式现实:无 heap 不等于省内存
本次 PC ABI 内存报告:
| 结构 | 大小 |
|---|---|
SolverContext |
141,980 B |
SolverResult |
8,736 B |
GameSnapshot |
304 B |
BFSNode |
16 B |
Context 内的大头包括约 79,872 B 的 A* 节点队列、9,984 B 的 heap index、4,608 B 的联合 visited 位图、36,864 B 的转向松弛数组和 4,096 B 路径 union。Context 之外还有:
- 推箱查询缓存约 14 KiB;
- 方向玩家搜索与识别转移表约 40–50 KiB;
- 4096 项递归状态表约 64 KiB;
g_result与第二识别候选各约 8.5 KiB;- 若启用
SOLVER_DEBUG_ENABLED,每个结果结构多出近 64 KiB 日志区,而且宏会改变 ABI。
历史 2026-07-20 Keil map 显示 RO 约 217.43 KiB、RW 约 372.86 KiB,名义 SRAM 余量约 76.1 KiB;但那份产物早于当前源码,不能证明现在仍能安全链接。尤其旧工程曾出现 .axf/.map 时间戳早于源码、Keil 项目引用旧副本、SDK 相对依赖缺失等版本漂移。
因此硬件适配的正确结论不是“6 箱数组已经改成 6,所以内存没问题”,而是:
- 算法维度已支持 6;
- 当前默认 profile 偏向 PC/大内存 MCU;
- 必须让调用方拥有 workspace,并提供 SMALL/MEDIUM/FULL 编译档;
- 用当前源文件 Clean Build 后检查 linker map、栈峰值和 DTCM/ITCM 放置;
- 真实 UART 日志与双识别会进一步影响时延。
十四、性能画像:现在快在哪里,仍慢在哪里
14.1 固定质量指标
相对独立仓库初始提交 c4744b9,48 张共同解地图的确定性结果是:
| 指标 | 初始提取版 | 当前版 | 变化 |
|---|---|---|---|
| 总转向 | 2,472 | 2,361 | -111 |
| 总步数 | 6,090 | 6,044 | -46 |
| 转向减少的地图 | — | 28 | — |
| 转向增加的地图 | — | 0 | — |
| 同转向但步数增加 | — | 0 | — |
| 完全相同 | — | 20 | — |
关键专项:
| 地图 | 基线 | 当前 |
|---|---|---|
| map3b2e 总路径 | 146 步 / 56 转 | 130 / 49 |
| 六箱识别 | 39 / 17 | 32 / 7 |
| 六箱完整路径 | 116 / 48 | 110 / 38 |
这些数字进入测试门禁,比一次 wall time 更可靠。
14.2 本次 wall time 与历史记录为什么不同
2026-08-27 性能文档记录 map 47 从约 22.7 s 降到约 9.9 s,map 50 从约 6.1 s 降到约 3.3 s。本次同一提交、另一运行环境中,普通回归分别约 16.25 s 与 5.38 s;profile build 中则是 14.255 s 与 5.711 s。
这不是结果不稳定:路径、转向、通过数和调用次数一致,变化的是机器、编译器调度和计时环境。文章因此不把“9.9 s”写成算法上界。
本次 profile:
| 地图 | 规划总时 | 推箱查询 | 推箱耗时 | 缓存命中 |
|---|---|---|---|---|
| map 47 | 14,255 ms | 54,077 | 13,614 ms | 27,977 / 51.7% |
| map 50 | 5,711 ms | 13,077 | 5,573 ms | 5,115 / 39.1% |
map 47 约 95.5% 的画像时间仍在 push-box BFS。玩家 BFS 在 profile 中几乎不可见,炸弹墙扫描也只占小部分。继续微调识别排序、哈希函数或日志无法解决这个数量级;热点已经定位到未命中的推箱查询。
14.3 2 秒止血做到了什么,没有做到什么
2026-07-20 针对慢六箱识别,先加入 50,000 次/800 ms 顺序预算与回退,再演化出 beam 和转移缓存。当前六箱专项整个测试只需数毫秒,远低于 2,000 ms 门禁。
这解决的是 recognition 爆炸,不是所有 planning 都低于 2 秒。map 14、23、47、50 在本次回归仍分别约 2.5 s、4.7 s、16.3 s、5.4 s。把“识别止血成功”写成“求解器实时化”是不成立的。
十五、验证体系:当前证据强在哪里,又缺什么
15.1 已有门禁
本次重新执行:
powershell -NoProfile -ExecutionPolicy Bypass -File tools/build.ps1powershell -NoProfile -ExecutionPolicy Bypass -File tools/test.ps1build/local/profile_maps.exe ` tests/regression/maps/map_00047_judge.txt ` tests/regression/maps/map_00050_judge.txtbuild/local/memory_report.exe通过的单测覆盖:
- 路径字符与切段合同;
- 重复标签、未知标签和默认配对;
- 返航修复;
- 越界路径执行;
- 推箱查询缓存;
- 递归状态缓存语义;
- 方向状态玩家最短路。
CI 在 Ubuntu 上以 GCC 与 Clang 构建,另跑 ASan/UBSan。50 图回归程序因为两张已知失败会返回 1,CI 明确要求“返回 1 + 50/50 + 48/50”同时成立,而不是把失败藏在绿色退出码里。map3b2e 和六箱质量也被锁住。
15.2 尚未覆盖的威胁
从研究方法角度,这套证据仍有外部与内部有效性限制:
| 威胁 | 当前情况 | 应补证据 |
|---|---|---|
| 语料代表性 | 50 图主要来自既有比赛地图 | 随机合法图、对抗图和属性测试 |
| 完备性 | 只知道 48 图有解,不能证明另外两图本身可解且当前算法漏解 | 独立参考求解器或人工证据 |
| Recognition 语义 | 门禁只看 solved/path,不逐项断言必扫目标 | 扫描覆盖 oracle 与零步测试 |
| 六目标解锁 | dummy visited 第六项风险未触发 | 专门构造第六目标邻接中断图 |
| 缓存哈希 | 双 64 位降低碰撞概率,但不做板面二次比对 | debug 模式存短签名或随机差分 |
| MCU 集成 | 当前独立仓库无固件 | 当前源码 Keil Clean Build、map 文件和硬件回放 |
| Wasm 同步 | smoke 只跑一张图 | 记录源码 commit/hash,增加小型浏览器回归集 |
| 取消与超时 | Worker 可杀进程,C 内核无检查点 | 统一 budget/cancel API |
因此当前“可复现”主要指 PC 上的确定性回归,不等于硬件闭环或全问题域证明。
十六、开发史:每一层架构都来自一次具体失败
16.1 单体阶段:先把功能做出来
最初的 bomb_box_synergy 以 solver_api.c / bfs / core / pairing / preclear / recog / solve 等大文件直接服务 MCU。炸弹分配散布为识别预推、解锁、Phase A、Phase B 和重定位五类;等效墙、弹箱协同和 Top-N 都在这一时期形成。优点是迭代快,代价是求解状态、协议状态与硬件时序难以分开诊断。
16.2 2026-07-16:先锁基线,再搬模块
重构没有从“重写一个更漂亮的求解器”开始,而是先固定:
- Recognition 50/50;
- Planning 45/50;
- 失败图 13、26、37、45、47;
- map 47 约 22.45 s;
- 每次结构迁移不得无说明降低通过率。
随后按 facade、context、board、txn、path、BFS、pairing、recognition、planning 和 MCU bridge 分阶段搬迁。这个选择保住了行为,但也让 solver_core_legacy.c 与部分全局状态被有意保留。
16.3 2026-07-20:识别超时先止血
六箱地图让排列增长到近似阶乘规模。第一反应不是“马上发明最优算法”,而是加评价次数与时间预算,超时直接回退简单策略,把现场计算压回 2 秒以下。之后才加入转移缓存、方向状态、精确小规模与 beam 大规模组合。
这是工程上正确的两步:先建立可用上界,再在上界内提高质量。
16.4 MCU 审计:很多“算法 bug”实际是边界 bug
历史排障覆盖过:
- 起点 waypoint 不能跳过,因为它承担必要纠偏;
g_dx/g_dy超大值不是求解路径变量,需查协议、日志参数、内存和旧固件;- L1 应由启动后第一关的状态机语义决定,不应由箱子数猜;
- recognition 结束后旋转混乱与 target/segment 对齐有关;
NEEDS_RESCAN、single skip 和 legacy pairing fallback 的调用层策略;- 固定
(6,1)回家、原起点回退与物理回家动作分离; - Keil 文件树可能引用另一份磁盘源码,旧
.axf会让“已修代码”根本没被烧录; - 16 字节临时路径、固定 24 个 push endpoint、先索引后判界等真实内存风险。
这些经历最终证明:算法库必须脱离 main.c 单独回归,而 MCU 必须通过清晰协议消费结果。
16.5 2026-08-27 至 08-29:独立 Git 仓库与底层优化
独立仓库建立后,七个提交完成:
- 抽取 CMake 静态库、测试、地图、画像与 CI;
- 修复越界路径执行和结果验证;
- 加方向状态识别、bounded order、推箱查询缓存并审计状态剪枝;
- 固化性能与工程评价;
- 重写整体 README;
- 修复动画测试可移植性;
- 归档 15 份去重后的历史开发文档。
规划通过率从 45/50 到 48/50,主要不是因为搜索空间无限扩大,而是 return repair 停止破坏已有解、识别顺序改善末状态、缓存消除重复查询,以及安全边界修复让结果可信。
十七、批判性工程评价:哪些地方已经可靠,哪些地方仍需怀疑
17.1 值得肯定的部分
问题合同比算法名字清楚。 两阶段 API、end_map、标签配对、路径字母表和最终回放把机器人工作流拆成了可诊断边界。
回归把目标函数写成数据。 通过数、转向、步数、六箱上限与关键图进入门禁,避免“速度变快但路径变差”只靠肉眼发现。
对缓存正确性保持克制。 推箱查询缓存使用完整板面;递归状态剪枝发现反例后默认关闭,没有为了漂亮命中率牺牲路径质量。
静态内存是显式选择。 这不是最省 RAM,但比在 MCU 上不可控分配更容易审计。
失败没有被粉饰。 map 37、47 仍然公开失败,回归退出码也保留这一事实。
17.2 P0:应在下一轮算法扩张前修复
- 用明确的扫描覆盖判据替换
recog_path_len > 0,补零步、无停车位与未开路目标测试。 - 把所有 6 元素 dummy visited 数组改为循环初始化,增加第六目标解锁回归。
- 统一 public header 与实现中的 debug 默认描述:实现默认静默 no-op,头文件注释仍说默认
fprintf(stderr)。 - 给
SolverInput.rows明确行宽合同或在核心入口验证每行至少w字符;网页桥已验证,裸 C API 仍较信任调用方。 - 为 Wasm 产物记录源码提交与 SHA-256,防止站点演示和文章版本漂移。
这些修改风险低、收益直接,而且可以完全由单元测试保护。
17.3 P0:真正的速度优化是玩家区域复用
对固定箱子布局,先做一次玩家 flood-fill,把所有可达玩家格压缩成 region ID。一个宏状态可写成:
M = (box_position, player_region, board_signature)边表示“玩家区域能到某推位 → 推箱一次 → 重新计算区域”。这样同一箱位置不必为每个玩家精确坐标重复搜索。之后才能:
- 把三遍 A* 合成统一宏搜索;
- 使用反向推箱距离作为 admissible 或受控启发;
- 加入角落、隧道、2×2 与目标占用死锁;
- 缓存 region transition,而不是完整字符路径查询;
- 在需要输出时再展开玩家区域内的具体步行路径。
这是 map 47 的直接热点治理,也是此前单遍联合搜索失败后最有依据的路线。
17.4 P0/P1:BombEffectGraph 比继续调墙分数更有价值
为每个炸弹—爆点候选预计算:
effect = { cleared_cells, connected_regions_before_after, new_box_push_sides, released_bombs, destroyed_deadlocks, bomb_push_cost}再以小规模 branch-and-bound 联合选择炸弹与墙,使用箱口反向推距、资源下界和重复效果上界剪枝。当前简单 clear count、默认配对 gain 和 5,000 组合枚举可以保留为快速候选生成器,而不再承担最终全局判断。
同号箱口也应先按 region、反向推距和死锁约束分等价类,只枚举真正不等价的匹配。这样“编号相同可任意配对”会从语义规则升级为搜索压缩手段。
17.5 P1:Workspace 实例化与完整事务
建议新增兼容 API:
size_t solver_workspace_size(SolverProfile profile);bool solver_workspace_init(SolverWorkspace *ws, void *memory, size_t size);void solver_recognition_with(SolverWorkspace *ws, const SolverInput *input, SolverResult *out);旧 API 继续包装默认静态 workspace。SMALL 关闭双候选和大缓存,MEDIUM 保留方向搜索与小缓存,FULL 保持当前质量。随后把 path checkpoint、pairing、失败状态和缓存代数逐步移入 workspace。
这一步同时解决可重入、平台裁剪和测试隔离,但不应与搜索算法替换放在同一个提交中。
17.6 P1/P2:规则层与搜索层还应继续分开
当前 solver_core_legacy.c、solver_solve.c 仍同时承担规则执行、候选生成、搜索调度和评分。渐进路线是:
- 抽出纯
board_rules:合法走、推箱、推弹、爆炸,不写全局路径; - 定义
SearchProblem与SearchResult; - 策略只产出宏动作候选;
- 统一 candidate commit、rollback 和 replay;
- 最后让 strategy registry 真正成为编排输入,而不是静态说明表。
不建议全面重写。当前 48/50 与路径质量门禁是最宝贵的资产,一次性替换规则、搜索、状态和评分会让回退来源无法定位。
十八、下一阶段可执行路线与验收标准
| 阶段 | 交付 | 验收 |
|---|---|---|
| A. 语义加固 | 修识别完成判据、第六目标 dummy、输入行宽、debug 注释;补单测 | 现有路径指标零回退,新增反例全通过 |
| B. Reachability layer | 固定箱布局玩家区域、推位枚举、region cache | map 47 push-box 时间明显下降;所有缓存差分测试一致 |
| C. Macro push search | 单次宏搜索替换三 pass 的实验开关 | 48 共同图转向不增加;同转向步数不增加;慢图更快 |
| D. BombEffectGraph | 爆炸效果、联合下界、失败引导扩展 | 不读取地图名;map 37/47 至少提升候选证据,最好新增完整解 |
| E. Workspace | 调用方内存、三档 profile、旧 API 包装 | FULL 与当前逐图相同;SMALL 有明确 SRAM 与能力表 |
| F. MCU reintegration | 当前源码 Keil Clean Build、linker map、协议回放 | 无旧文件漂移;起点纠偏、L1、返航和 DEV 链路分别验证 |
质量门禁继续按以下顺序:
- 合法完整解与最终重放;
- 识别覆盖与配对正确;
- 转向不增加;
- 转向相同时总步数不增加;
- 运行时间与内存;
- 代码结构。
算法速度不能以牺牲完成率和目标函数换取;重构也不能以“文件更漂亮”为理由改变搜索结果。
十九、最终评价:这套工程真正完成了什么
它最有价值的成果不是某个 BFS,也不是一张动画。它把一个曾经混在机器人状态机里的复杂任务,拆成了一组可以独立质疑、测试和复现的合同:
- 识别路线会改变地图,所以必须交付
end_map; - 同号对象是等价候选,不是数组位置绑定;
- 单个漏识别可以由多重集合恢复,但歧义必须显式暴露;
- 炸弹是拓扑变换,缓存和快照必须包含墙状态;
- 推箱为弹开路、弹为箱造空间需要真正事务式试探;
- 完成、转向和步数有明确优先级;
- 找到候选不是结束,完整字符重放才是答案;
- MCU 运动异常、协议错误和求解错误必须在边界上分开;
- 历史失败和当前失败都应进入门禁,而不是从报告中删除。
它也远没有“彻底完成”:识别成功语义仍有漏洞,六目标解锁有一个具体初始化风险,默认配对与全局目标不完全一致,推箱三 pass 吞掉绝大多数时间,状态所有权仍是全局的,策略注册表还只是文档,两个地图仍无规划解,硬件也缺当前源码的发布级 Clean Build。
所以对当前版本最公允的评价是:
它已经是一份可信的稳定基线和研究平台,足以继续做底层算法;但若要成为可复用、可并发、可裁剪且更接近完备的求解库,下一阶段必须先修判定语义,再做玩家可达域复用和炸弹效果图,最后才轮到大规模架构替换。