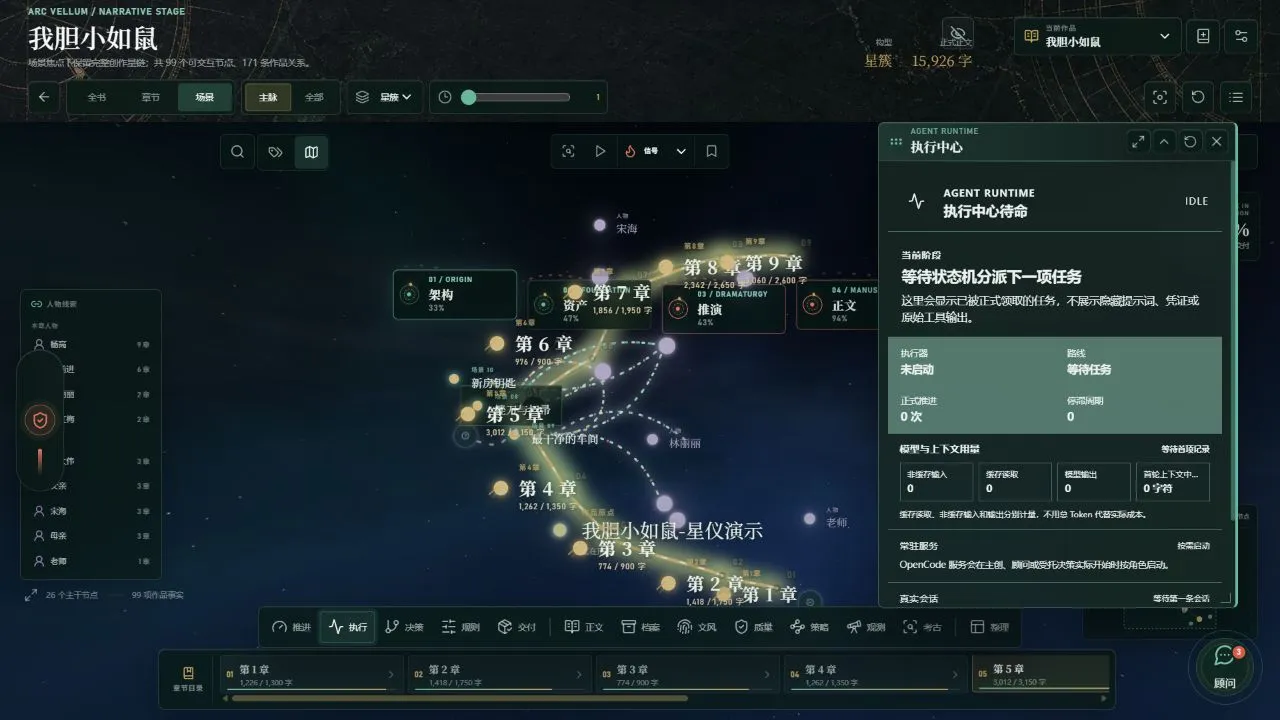
ArcVellum 的内置 Agent 需要完成结构化资产、角色推演、分支选择、正文、审查和状态补丁。直接把 Coding Agent 放进项目根目录能够获得很强的自由,也会带来长上下文、任意文件访问、Shell 依赖和难以复现的执行行为。
Pi Worker 的定位是受控文学任务解释器。它接收已经编译的 TaskPackage,调用模型完成需要语义判断的部分,再把输出交回 Studio 和 Engine。它不拥有项目状态机,也不自行决定哪些候选已经成为正式作品。
三层职责
| 层 | 职责 | 保持的权力 |
|---|---|---|
| Engine | 路线、任务合法性、Gate、晋升、Canon 与写回 | 正式作品资格 |
| Studio | Runtime 生命周期、沙箱、工作区、预检、恢复、事件流 | 执行控制 |
| Pi Worker | 理解文学任务、按需读取、生成语义载荷、报告阻断 | 创作与判断 |
这个边界使 Worker 可以升级、替换模型或增加工具,而不会重新实现 CLI 规则。
双工作区
每次运行拥有两个隔离视野。
control-workspace
由 Studio 与 Engine 使用。它包含完整 source_paths、命令依赖、Schema、历史证据和预检需要的中间文件。模型看不到这部分完整内容。
workspace
由 Pi Worker 使用。它只包含 agent_source_paths、当前任务说明、允许按需读取的资料和声明输出位置。Worker 的文件写入被限制在 expected_outputs。
formal project -> control workspace: complete validation view -> agent workspace: curated literary view -> Worker output -> deterministic preflight in control workspace -> transactional writeback双工作区解决了权限与验证的矛盾:模型不必看见整个项目,CLI 仍能获得完成命令所需的全部正式证据。
七个受限工具
Pi Worker 的常规工具面保持很小:
| 工具 | 用途 |
|---|---|
read_task_context |
读取当前任务的核心合同与内联证据 |
read_authorized_source |
精确读取白名单中的必要资料 |
write_expected_output |
写入任务声明的输出 |
validate_output |
在提交前执行本地形状检查 |
complete_task |
声明本次语义工作完成 |
request_repair |
请求有限修复并附带原因 |
report_blocker |
报告缺失证据、权限或不可满足条件 |
修复模式可以增加 read_repair_target。工具数量保持克制,因为每个工具都会增加选择成本、提示词长度与测试面。文学概念适合进入任务语义,确定性动作适合进入少量稳定工具。
两类执行策略
direct-submit
任务核心证据已经内联,输出格式明确,模型可以直接生成语义载荷。例如简单人物资产、短结构摘要和明确字段补全。减少不必要的工具往返能够显著降低时延。
evidence-then-submit
任务需要比较原始文本、核对多个来源或解释候选差异。Worker 先读取准确证据,再生成输出。例如正文审查、文风抽象和复杂 Canon 冲突判断。
执行策略由任务编译器根据 task type、证据策略和风险决定。模型可以请求缺失证据,但不能把任何任务都扩张成遍历整个项目。
LiteraryTaskSpec
Pi 专业化的高收益方向是把通用 TaskPackage 投影成紧凑的 LiteraryTaskSpec。它描述:
- 文学任务类型和本次目标;
- 输入证据的核心、摘要与按需层;
- 产物类型、语义字段和禁止改变的事实;
- 主创、审查、规划等角色 Profile;
- 推理档位与输出预算;
direct-submit或evidence-then-submit;- 完成、修复与阻断条件。
Studio 编译这个 Spec,Pi 只解释并执行。Schema、文件来源、writer session、哈希与 completion marker 等可确定元数据由宿主补齐,模型集中返回文学语义。
提示词生命周期
Pi Worker 的稳定规则适合持久化,例如工具语义、权限边界、阻断报告和输出纪律。每次请求只发送当前任务差异:文学目标、核心证据、当前约束和输出合同。
正文、审查和结构化任务使用不同 Recipe。推理强度也应分层:
| 任务 | 建议推理档位 |
|---|---|
| 字段整理、索引、格式化 | 低 |
| 角色推演、分支比较 | 中 |
| 正文生成、文风抽象 | 中至高 |
| 复杂审查、全局冲突 | 高,带严格预算 |
统一使用最高推理强度会拉长时延;统一压低推理会损害文学判断。任务类型应决定预算。
无进展检测与有限修复
Agent 运行中最昂贵的失败是反复读取、反复解释,却没有产出。Studio 记录工具事件、输出变化和 Provider 活动。长时间没有可见活动、重复读取同一资料或连续收到相同预检错误时,运行进入无进展状态。
系统随后选择:
- 给出更精确的缺失产物和失败位置;
- 进入有限 repair turn;
- 回收当前进程并保留运行证据;
- 将任务标为可恢复阻断;
- 在预算允许时换模型或执行策略。
修复轮次受到上限约束,避免模型在无法解决的合同错误上持续消耗。
并发与会话复用
只读分析、不同场景的资料摘要和互不写入的审查可以并行。正式正文保持主创 Agent 单一责任;共享 Canon、人物状态或章节账本的写入必须经过读写集冲突检查。
Worker 会话可以复用稳定规则、模型连接和缓存摘要,却不能把上一任务的候选事实带入下一任务。项目 revision 与 TaskPackage 仍决定当前证据。
结束、取消或失去租约的 Worker 应被回收。Agent 进程面板展示 session id、task id、模型、状态、事件、Token、时延和最近活动,帮助用户辨认真实运行、等待 Provider 与空转。
成本收益基线
Prompt v3 已将一个正文合并提示从 189,908 字符降至 29,218 字符。现有 A/B 样本显示:
| 任务 | 总 Token 变化 | 成本变化 | 时长变化 |
|---|---|---|---|
| 结构化任务 | -31% | -28% | -17% |
| 审查任务 | -16% | -4% | +7% |
这组数据表明,提示词压缩有价值,运行时仍需优化工具往返、Provider 延迟和失败恢复。Pi 专业化按指标推进,优先落地 LiteraryTaskSpec、双执行策略和语义载荷提交。
复杂多 Agent、跨任务自主编排和大量领域工具暂缓,除非真实作品闭环证明它们能降低 Token、修复轮次和 P95 时延,同时保持一次通过率。
Provider 与本地模型
Pi Provider Catalog 可以连接常用 API 与 OpenAI-compatible 端点。模型选择按角色持久保存,正在运行的任务不被粗暴切换;新任务读取最新配置。
本地小模型适合结构化任务、索引和部分静态审查。正文与复杂文学判断能否使用小模型,取决于题材、上下文压缩和 Profile 质量,需要用盲评与 Gate 通过率验证。系统架构允许混合路由,避免把所有任务绑定到一个昂贵模型。
当前投资边界
Pi Worker 值得继续专业化,前提是保持薄领域内核和强确定性宿主。近期不在 Worker 中复制状态机、Canon Policy、Promotion 或全局编排;也不把完整聊天历史频繁送入模型。
这条路线让 Pi 获得足够的文学任务感知,同时让每次增强都能用真实 Token、时延、修复率和作品质量衡量。