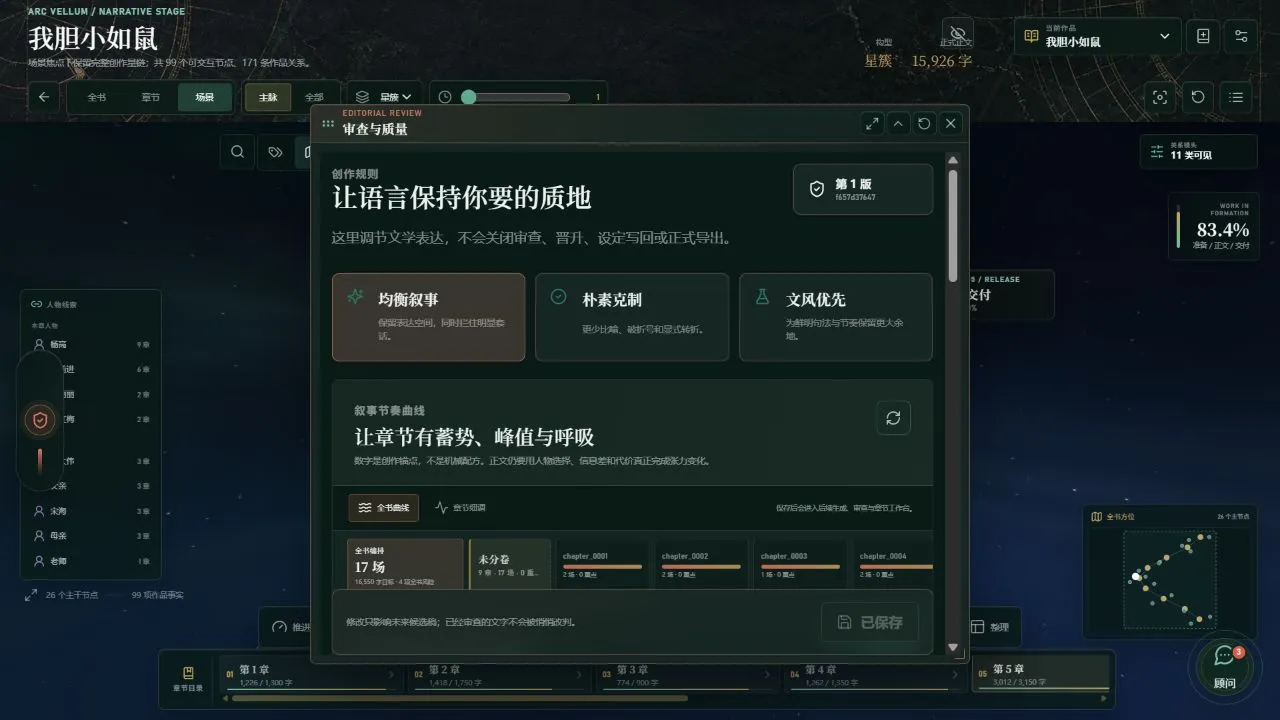
审查系统的价值不在于生成一份评论。它需要阻止不合格候选进入正式正文,也需要把可操作的问题送回下一次修订,并证明修订后的内容重新接受了检查。
长篇文学的质量问题横跨多个尺度。一个句子的标点可能机械,一场戏可能缺少转向,一章的张力可能均匀,全书的承诺可能长期未兑现。ArcVellum 将审查组织成分层 CI,让每种判断在合适的层次发生。
两类判断
确定性检查
代码擅长处理能够明确计算的条件:
- 文件、Schema、字段与来源是否完整;
- 审查对象的内容哈希是否匹配;
- 汉字目标与机器字符数是否落在允许区间;
- 禁用句式的变体、破折号比例和标点形式;
- expected outputs 之外是否有写入;
- 完成凭据是否晚于当前任务签发;
- promotion、state、Canon 与 continuity 的身份链是否闭合。
语义 AgentReview
模型负责需要文学理解的判断:人物选择是否来自既有动机,冲突、转向与代价是否成立,场景是否接住上一场并推动下一场,文风约束是否产生自然文本,读者问题与信息释放是否有效,修订是否真正解决问题。
确定性检查给审查提供精确位置和统计,语义审查决定这些现象在当前文本中的文学意义。
Review 输入合同
一次正式场景审查至少读取:
- exact candidate 正文与内容身份;
- 场景 YAML 和 composition;
- context trace 与相关 Canon;
- 出场人物状态和背景影响;
- 字数、节奏、衔接、读者体验合同;
- 挂载文风和项目标点策略;
- 确定性 Style Lint 结果;
- 上一场结尾与下一场义务。
这些输入由 agent-review-scene 任务包下发。审查 Agent 只负责判断,不修改正文;主创 Agent 负责正式修订,避免同一角色在检查时顺手重写并宣称通过。
Style Lint 作为硬前置证据
纯语义审查容易漏掉标点变体。例如机械对照句可以改变连接标点,表面避开单一字符串。Lint 将这些形式归入同一修辞模式,输出位置、规则、样本与严重度,再注入 AgentReview。
Lint 的职责是报告可疑模式和硬阈值。它不使用通用正则直接改写正文,因为自动删除否定词可能反转语义,也可能误伤某种风格的有效修辞。
项目允许为部分软规则配置低比例例外,例如全文中少量惯用表达。硬禁令、项目级自定义规则和语义冲突仍会阻断。例外必须按规则统计,不能靠替换标点规避检测。
审查结果模型
| 结论 | 后续动作 |
|---|---|
pass |
可进入晋升门禁 |
pass_with_notes |
必须先完成明确的小幅修订与复核 |
revise |
进入正式 revise-scene,处理指定问题 |
reject |
回退到分支、composition 或重写策略 |
pass_with_notes 不表示“可以忽略建议”。Notes 需要带位置、问题、影响、修订目标和验证方法,修订后重新检查 exact revised candidate。
修订任务的批判性合同
revise-scene 读取正文、Review notes、文风、Canon、字数与节奏目标,输出修订候选和修订报告。它遵守几条强约束:
- 只改审查指出的问题及其必要上下文;
- 不能用另一种机械转折替换被禁止的机械转折;
- 若保留高风险修辞,需要说明它承担的节奏或认知功能;
- 解释必须接受反例检查,不能用“增强文学性”作为空泛理由;
- 不改变场景事实、适用范围和后续钩子;
- 不用增加形容词、器官反应或比喻堆叠填补字数;
- 修订报告列出 changed spans、保留理由和潜在副作用。
正式复核会重新运行 Lint 和 AgentReview。原审查报告无法覆盖已经变化的内容身份。
场景门禁
context and trace + roleplay completion + branch selection + composition provenance + word target + reader contract + generation provenance + deterministic lint + exact AgentReview + revision evidence when required -> promotion晋升后仍需完成静态检查、人物状态补丁、Canon 候选和连续性账本。作品的后续场景读取这些正式变化,因此场景审查既保护当前文本,也保护未来上下文。
章节级审查
单场景全部合格,章节仍可能阅读乏力。章节工作区检查:
- 场景功能是否重复;
- 张力曲线是否有呼吸和层次;
- 对话、动作、叙述、心理与环境纹理是否单一;
- 场景桥是否形成因果咬合;
- 章节结尾是否总用同一种悬念句;
- 字数欠账是否来自事件库存不足;
- 读者问题与 Promise/Payoff 是否按本章义务推进。
章节审查不会用扩写句子解决结构欠账。事件库存不足时,应增加有功能的场景、关系变化或余波,而非把现有场景写得冗长。
长篇审计
longform-audit 关注跨卷问题:主线、支线和人物弧是否长期停滞;某类场景、视角或语言纹理是否过度集中;读者问题是否拖延过久;承诺是否得到兑现、反转或解释;时间跨度、人物年龄、地点移动和组织变化是否连续;总字数、事件库存和详略分配是否仍可兑现。
长篇审计输出欠账列表和后续任务建议,不静默重写已晋升正文。
文风审查的边界
频率指标只能提供信号。某位作者的节奏可能依赖高密度破折号,某一场急促对话也可能需要短句。Review 应区分有功能的风格特征和模型惯性。
因此文风文件需要声明典型句法、适用场景、反例、密度范围、允许偏离条件和语义判断问题。Lint 使用项目阈值,AgentReview 使用具体风格证据,二者共同工作。
审查者独立性
正文由主创 Agent 完成。审查可以使用独立 Profile、不同模型或独立上下文,使它不延续写作时的自我辩护。Subagent 适合做确定性资料整理、位置索引和证据核对,不承担正式正文创作。
对成本敏感的项目可以让轻量模型执行结构化检查,让能力更强的审查 Agent 处理人物、节奏和文风判断。所有结果仍进入同一 Gate。
可观测指标
- 首次
pass比例; pass_with_notes到复核通过的比例;- 每场平均修订轮次;
- Lint 误报和漏报样本;
- 审查与晋升 candidate mismatch 次数;
- 章节欠账和长篇欠账关闭速度;
- 审查 Token、时延和 Provider 往返;
- 读者盲评与机器 Gate 的相关性。
审查质量最终落在正文、读者体验和长期连续性上。报告数量只是过程指标,晋升后的作品状态才是系统结果。