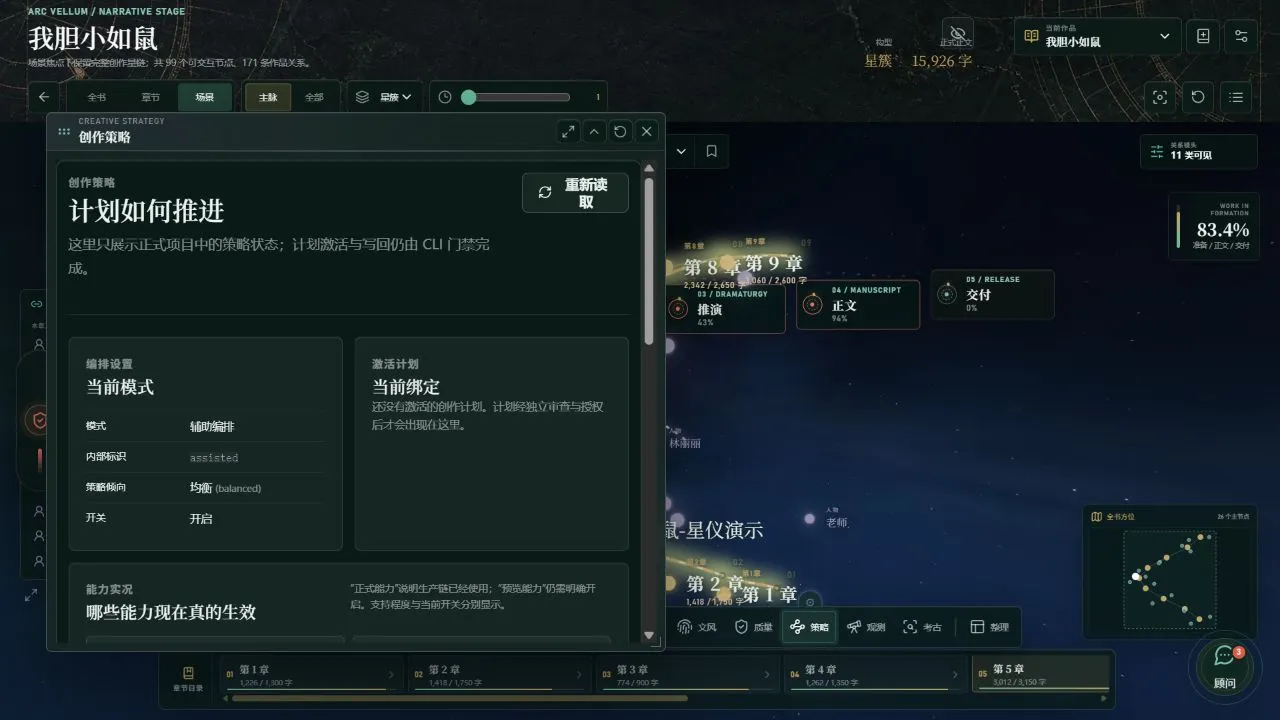
长篇写作中的上下文问题具有两个相反的风险。资料太少时,模型会忘记人物状态、擅自改变 Canon、重复已经兑现的伏笔;资料太多时,模型的注意力被历史文档、流程说明和无关场景占据,输入成本上升,文学任务反而变得模糊。
ArcVellum 把上下文准备视为一次编译。输入是完整项目、当前路线和当前任务,输出是一份有限、可解释、带来源证明的任务上下文。模型得到的材料应当足够完成任务,也应当足够小,使核心矛盾、文风和产物合同保持显眼。
上下文编译的目标函数
一次有效编译同时优化五个量:
| 目标 | 需要避免的失败 |
|---|---|
| 事实覆盖 | 遗漏当前场景、主要人物、禁止变化或上一场余波 |
| 任务相关性 | 把未来章节、旧审查和开发说明混入当前注意力 |
| 文学完整性 | 只给结构字段,丢失足以支撑语气与选择的具体文本 |
| 成本 | 每轮重复发送整部 Canon、全部角色和长篇 Skill |
| 可追溯性 | 模型声称读过资料,系统却无法证明来源与版本 |
因此,Context Broker 不以“塞进多少文件”为完成标准。它需要回答:当前决策依赖哪些事实,每项事实来自何处,哪些资料被摘要,哪些资料被排除,排除是否会破坏任务。
从项目状态到 Context Trace
正式场景会生成可读的 context packet,同时生成机器可校验的 context_trace。Trace 保存当前 scene id、加载文件、摘要文件、排除文件、缺失组、文风挂载、字数预算、人物资产、Canon 资产、上一场尾部以及长度预算。
project facts -> required context groups -> source resolution -> load / summarize / exclude -> context packet -> context trace -> reading receipt这条链解决了一个关键问题:一份看起来完整的 Markdown 无法证明它包含了最新人物状态。Trace 可以记录准确路径、版本和摘要方式,后续角色推演、分支、编剧态、正文与审查共同引用同一批证据。
当 missing_required_context 非空时,场景生成会被阻断。Agent 无法用一句“已阅读相关设定”替代缺失证据,也无法手写一个来源不明的 JSON 获得正式身份。
三层证据投递
ArcVellum 将资料分成三层,从而控制每次请求的固定开销。
核心内联证据
这部分直接出现在提示词中,通常包括:
- 当前场景目标、冲突、功能与完成条件;
- 当前出场人物的稳定特征与动态状态;
- 与本场直接相关的 Canon 和 forbidden changes;
- 字数、节奏、衔接、读者效果与已挂载文风;
- 输出 Schema、允许写入范围与当前 Gate。
模型无需调用工具即可开始理解任务,且最重要的信息始终靠近指令。
压缩摘要证据
章节历史、关系变化、读者问题账本和连续性账本适合先转为面向当前任务的摘要。摘要需要保留事实来源与时间位置,不能把多个互相矛盾的候选压成单一陈述。
精确按需证据
原始场景全文、较远角色背景、历史审查和低频世界设定由受限读取工具提供。任务包声明允许访问的路径,Worker 只有在遇到明确的信息缺口时才读取。按需读取的价值来自减少固定 Token;如果每次任务仍机械读取所有路径,这层设计就失去意义。
Prompt Recipe 如何组织约束
项目中的提示词并非一份不断增长的总说明。Prompt Registry 按任务类型维护 Recipe,例如 structured、planning、creative、prose、review、style 与 archaeology。每份 Recipe 描述:
- 任务身份与文学目标;
- 已授权的证据和读取方式;
- 不可删除的硬约束;
- 当前可自由判断的创作空间;
- 输出格式、文件身份与验证方式;
- 失败时怎样报告阻断或请求修复。
任务包优先匹配精确 Prompt Asset,再使用受控通配资产。正文、审查、修订等高风险任务可以拥有各自的精确资产,避免通用说明稀释关键约束。
文学任务中最重要的上下文组
事实组
Canon、时间线、地点、组织、人物身份与禁止变化决定“什么可以发生”。
动机组
belief、desire、intention、fear、secret、moral line 与 background story 决定“人物为什么这样选择”。背景故事影响回避、误判、语气和承诺,不要求在正文中直接解释。
叙事组
scene function、rhythm role、narrative distance、incoming pressure、outgoing hooks 与 reader effect 决定“这一场以什么速度和距离发生”。
长篇组
字数目标、事件库存、Promise/Payoff、Reader Question 与章节义务决定“这场对全书负责什么”。
文风组
挂载的风格约束、标点策略、句法偏好、禁用惯性表达和允许例外决定“语言如何承载内容”。文风在生成时进入任务,而非等到审查才出现。
Prompt v3 的压缩策略
长期运行暴露过一种典型低效:任务包把项目说明、Skill 规则、Agent 初始化文本、源文件摘录和输出合同全部重复拼接。正文合并提示词一度达到 189,908 字符。Prompt v3 将重复协议移回持久化 Worker 规则,把当前任务压缩成结构化证据与文学合同,正文示例降至 29,218 字符,固定字符量减少约 84.6%。
压缩并不等于删除文学要求。有效做法包括:
- 只发送当前任务变化的事实;
- 将重复流程规则编码为稳定 Recipe 与工具语义;
- 用路径、摘要和哈希引用已知证据;
- 把可确定生成的元数据交给宿主代码;
- 让模型主要返回文学语义载荷;
- 按结构化、正文、审查分别设置推理档位和硬上限。
现有 A/B 样本中,结构化任务总 Token 下降约 31%,审查任务总 Token 下降约 16%。审查时延没有同步下降,说明工具往返、Provider 延迟和失败恢复仍需单独优化。
一致性比长度更重要
上下文系统最容易出现的缺陷是合同分裂:提示词告诉模型可以按需读文件,Worker 循环却优先要求写输出;任务包展示很多项目资料,沙箱实际只授权精简集合;审查要求读取精确候选,任务上下文却引用旧稿。
ArcVellum 对这些问题采用同一条修复原则:模型看见的能力、工具真正允许的能力和确定性预检期待的能力必须一致。任何一层扩大或缩小范围,都要通过同一任务合同传播。
缓存、失效与重建
上下文缓存必须与项目版本绑定。人物状态、场景 YAML、挂载文风或字数预算发生变化后,旧 Trace 会失效。系统用来源摘要与内容身份判断是否需要重建,而不是只看文件名是否存在。
缓存适合保存:
- 稳定 Canon 摘要;
- 角色背景与近期状态的分层摘要;
- 已验证的文风 Profile;
- 章节级读者账本摘要;
- Prompt Recipe 的解析结果。
当前场景冲突、候选正文、审查结论和状态补丁具有强时效,应随任务身份重算。
如何验证上下文质量
上下文质量需要同时看静态证据和真实结果:
| 验证项 | 可观察指标 |
|---|---|
| 覆盖 | required groups 完整,Trace 无缺失 |
| 精确 | 来源版本、scene id、candidate hash 匹配 |
| 紧凑 | 输入 Token、重复段落率、按需读取次数 |
| 有效 | 一次 Gate 通过率、Canon 错误率、修订轮次 |
| 稳定 | 相同项目版本产生可复现的任务上下文 |
一份优秀上下文不会替模型完成创作。它把作品事实、文学问题和正式边界同时摆在模型面前,让模型把注意力用在真正需要判断的部分。