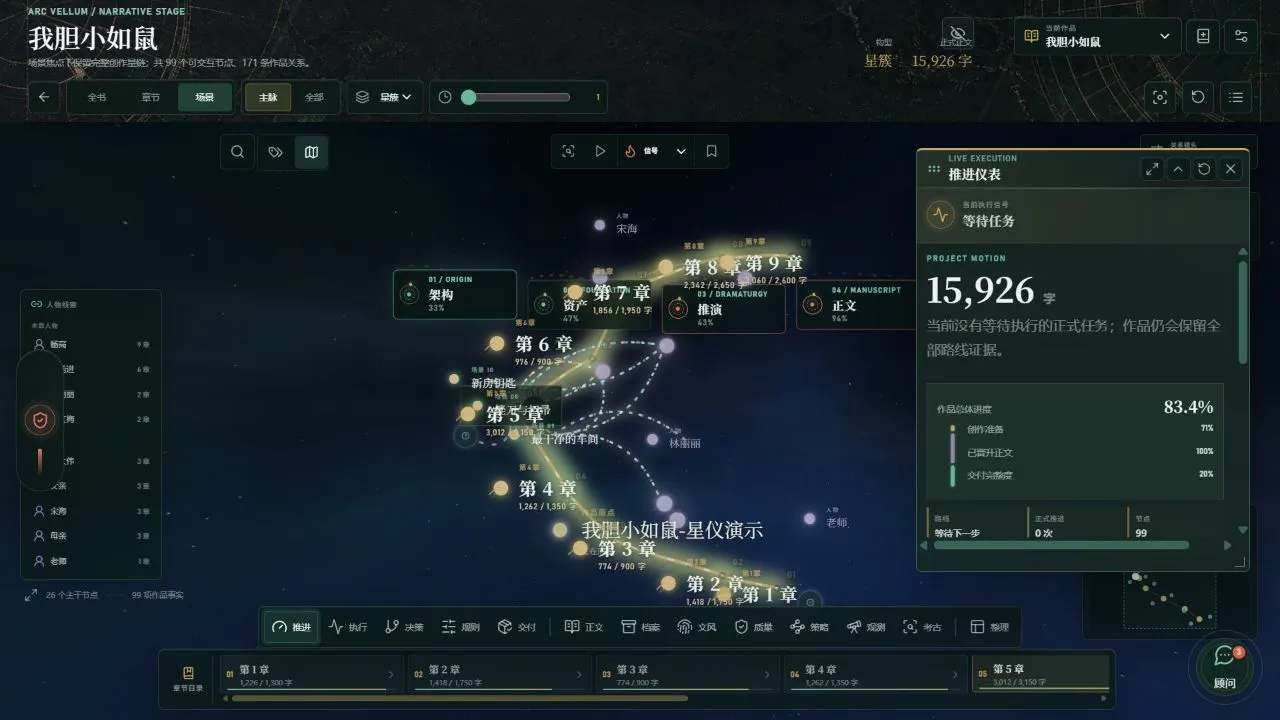
场景是 ArcVellum 中最完整的求解单元。它足够小,可以得到明确输入和输出;又足够大,能够改变人物、关系、读者认知和后续剧情。scene-development 路线把这项创作拆成确定性准备、语义判断、正文生成、质量闭环和事实写回。
场景问题的形式化表示
一项场景任务可以概括为:
Given: 当前 Canon、人物状态、时间地点、上一场后果、读者账本、文风和字数预算Find: 一组符合人物逻辑且具有戏剧效用的行动与叙事表达Such that: 场景功能完成、因果成立、篇幅合理、语言达标、后续仍有可用空间Produce: 正文候选 + 审查证据 + 状态/Canon/连续性变化候选求解过程保持两种计算互补:程序擅长路径、身份、Schema、统计和 Gate;Agent 擅长人物处境、叙事选择、语言表达与语义审查。
第一阶段:构造可追溯上下文
context 命令根据场景参与者、地点、时间、当前卷章、活跃承诺和文风挂载生成 Context Packet。与正文一起产生的 Context Trace 记录每一组资料的来源和摘要。
上下文包含:
- 场景定义、目标、冲突、功能和目标字数;
- 主要人物与实际参与的次要人物;
- 人物的 BDI、恐惧、秘密、道德线、背景故事与当前状态;
- Canon 与禁止变化;
- 前一场离开钩子和当前进入压力;
- 当前读者问题、承诺、暂扣与兑现计划;
- 章节节奏位置和叙事距离;
- 已挂载文风、标点与语言限制;
- 需要精确按需读取的证据索引。
Context Trace 让 Gate 能判断 Agent 是否收到关键事实。路径缺失、摘要过期和必读组遗漏会在正文之前暴露。
第二阶段:角色推演
simulate-scene --agent 先创建推演骨架和独立任务。主创 Agent 随后从每个角色自己的知识和动机出发回答:
- 当前相信什么;
- 最想避免什么;
- 会采取什么具体行动;
- 哪些方便剧情的行动会被人物逻辑排除;
- 选择会给下一场留下什么代价;
- 背景故事怎样通过选择、回避、误判或语气间接显现。
World Agent 视角再计算行动碰撞后的直接后果、Canon 冲突和下一场压力。推演结果保存为结构化语义产物,完成标记由 Studio 在预检通过后写入。
正文只允许主创 Agent完成。只读子任务可以帮助整理资料、比较证据或执行机械检查,无法并行生成正文片段后拼接,以免叙述声音和局部事实分裂。
第三阶段:生成并比较分支
branch-simulate --agent 把角色行动组合成多个候选分支。每个分支需要说明:
- 关键行动和因果链;
- 场景转向与结束状态;
- 对人物弧、关系、Canon 和读者问题的影响;
- 戏剧收益、文学风险和后续可写空间;
- 目标字数与节奏是否能够承载;
- 合并其他分支元素时的冲突。
评分只用于辅助比较。正式 branch_selection.md 需要记录选中分支、理由、保留元素、排除理由和写回风险。人工模式下,前端把高影响选择展示为决策卡;全自动模式由受托决策策略处理,决定仍进入审计账本。
第四阶段:编剧态编译
compose-scene 将选中分支编译成正文任务的直接合同。Composition 汇总:
- 事件节拍与信息释放顺序;
- 场景功能、转向和读者效果;
- 叙事视角、距离和节奏;
- 对话、动作、心理、环境的比例;
- 目标字数、容差和展开点;
- 进入压力与离开钩子;
- 文风生成标准、禁止模式与标点规则;
- Canon、人物状态和承诺边界;
- 正文输出路径和完成条件。
编剧态通过后,Agent 收到的是一项已经收束的问题。它仍然自由选择句子、细节和现场调度,无法自行缩短场景义务或跳过关键后果。
第五阶段:生成正文候选
场景正文由独立的主创角色执行。Prompt v3 将稳定身份、任务合同和高价值证据分层组织,减少重复的 Skill 说明和项目文件清单。正文写入候选路径,并记录当前任务、Prompt Asset、上下文摘要和内容指纹。
生成约束直接进入本阶段:文风、叙事节奏、目标字数、视角、场景桥接、标点和语言习惯都在下笔前生效。确定性反模板规则限制机械对照、器官轮岗、空泛隐喻和破折号惯性,同时保留少量由文风明确支持的例外比例。
第六阶段:双层审查
审查分成机器可判定和语义判断两层。
确定性检查
- 候选存在且来自当前任务;
- 中文内容字符位于场景目标容差;
- 标点、禁用模式和组合密度满足项目规则;
- 必需结构、内容摘要和来源字段完整;
- Review 指向精确候选;
- Agent 没有写出允许路径以外的文件。
AgentReview
- 人物行动是否来自既有动机;
- 场景功能和转向是否真正发生;
- Canon、时间、地点与知识范围是否自洽;
- 文风是否在句法、节奏、视角和细节选择上成立;
- 上一场压力是否得到承接;
- 下一场钩子是否自然产生;
- 读者问题和承诺处理是否合理;
- 语言是否存在模板化、解释过度和节奏扁平。
Style Lint 的确定性发现会注入 AgentReview。模型负责判断语境和修改方式,正则负责发现变体与密度,二者共同避免“改一个标点就绕过规则”。
第七阶段:修订与复核
pass_with_notes 会产生必须处理的局部动作。revise-scene 读取精确候选、Review notes、文风、Canon 和字数目标,生成修订候选与修订报告。
修订禁止用另一种模板转折替换原问题。若保留受限表达,报告需要说明它承担的语义功能,并接受倾向挑刺的复核。修订以后重新执行 Lint 与 AgentReview;旧候选的通过记录不能继承。
连续失败会触发策略判断:局部修订、完整重写、回到分支或回到规划。系统限制无价值循环,要求每轮增加可验证作品状态。
第八阶段:正文晋升
promote-candidate 在正式写入前重新计算:
- 候选内容摘要;
- Review 目标摘要;
- Style Lint 和字数;
- Context、RP、Branch、Composition 与生成 provenance;
- 新角色登记;
- 人工或自动批准身份;
- 所有 sidecar 的 completion 状态。
通过后,正文复制到正式草稿并生成 Promotion Manifest。阅读器只读取这部分已晋升内容。
第九阶段:后果写回
正文晋升以后,项目需要吸收叙事后果。
state-evolve生成角色状态和关系 patch;- Agent 审查变化是否由正文支持;
- 高风险 patch 进入批准;
state-apply原子应用并记录摘要;canon-evolve提取世界事实候选;- Continuity Ledger 记录物件、伤势、知识、时间和承诺变化;
- 账本审查通过后应用;
- 下一场 Context Packet 读取新状态。
这样,上一场正文造成的后果会成为下一场的真实输入,形成持续闭环。
进入下一场的条件
场景结束需要同时满足:正式正文已晋升,状态变化已经审查与应用,Canon 候选已处理,连续性账本完整,Route Audit 通过。下一场的上下文以这些事实为基线。
章节完成后还要运行 Chapter Workspace 与节奏审计,检查场景之间的因果链、字数总量、章节结尾、问题/承诺账本和人物弧。长篇系统的“完成”始终带有尺度:文件完成、场景完成、章节完成、作品完成各有不同 Gate。
求解器保留的开放空间
固定路线约束正式状态迁移,文学过程仍可以自适应。Agent 可以决定推演深度、分支数量、场景拆分、信息顺序、叙事距离和修订策略;系统注入不可删除的 Canon、字数、文风、连续性和审查 Gate。
这种设计让场景求解拥有足够的文学自由,同时给长篇项目提供可持续的因果、版本和质量结构。